
-i6a77249e192b0.png)

Vector Database Nedir? Yapay Zekânın Harici Hafızası Nasıl Çalışıyor?
Bir yapay zekâ asistanına şirketin yeni iade politikasını verdiğinizde, model bu bilgiyi kalıcı olarak öğrenmiş olmayabilir. Belge mevcut konuşmada kullanılabilir; fakat başka bir oturumda tekrar erişilebilir olması için ayrıca saklanması ve gerektiğinde bulunması gerekir.
10/10/2026 21:34 | Son Güncelleme : 11/10/2026 01:12 | Netosfer

Vector Database (Vektör Veritabanı), bu erişim mekanizmasının parçalarından biridir. Belgelerin veya kayıtların sayısal temsillerini saklar ve kullanıcının isteğiyle benzer içerikleri bulmaya yardımcı olur.
Bu nedenle vektör veritabanları bazen yapay zekânın “hafızası” olarak adlandırılır. Ancak bu bir benzetmedir. Veritabanına bilgi eklemek, dil modelinin ağırlıklarını değiştirmez. Model, bulunan bilgiyi kendisine sunulan bağlam üzerinden kullanır.
Vector Database Nedir?
Vektör veritabanı, sayısal vektörleri saklama, indeksleme ve benzerlik araması yapma özellikleri sunan bir veritabanıdır.
Yapay zekâ uygulamalarında bu vektörler çoğunlukla embedding modelleriyle oluşturulur. Metin, görüntü veya ses gibi içeriklerin belirli özellikleri, çok boyutlu sayısal temsillere dönüştürülür.
Bir belge için oluşturulan temsil şöyle görünebilir:
[0.18, -0.62, 0.91, ...]
Bu sayıların her birine doğrudan “fiyat”, “ürün” veya “iade” gibi bir anlam vermek genellikle mümkün değildir. Temsil, bileşenlerin birlikte oluşturduğu ilişkiler üzerinden kullanılır.
Ayrıca veritabanı yalnızca vektör tutmak zorunda değildir. Kaynak metin, belge kimliği, tarih, kategori ve erişim bilgileri de kayıtlara eklenebilir.
Modelin Bilgisi ile Harici Hafıza Arasındaki Fark
Bir yapay zekâ sisteminde bilgi birkaç farklı yerde bulunabilir.
| Bilginin bulunduğu yer | Nasıl kullanılır? | Temel sınır |
|---|---|---|
| Model ağırlıkları | Eğitimle öğrenilen örüntüler üzerinden | Yeni bilgi kendiliğinden eklenmez. |
| Konuşma bağlamı | Mevcut isteğe verilen içerik üzerinden | Bağlam uzunluğu ve oturum yönetimiyle sınırlıdır. |
| Harici kayıt sistemi | Gerektiğinde getirilen bilgiler üzerinden | Saklama ve arama kalitesine bağlıdır. |
Vektör veritabanı, üçüncü katmanda görev alabilir. Ancak harici hafızanın tek biçimi değildir. Yapısal veritabanları, dosya depoları ve diğer arama sistemleri de kullanılabilir.
Bilginin saklanması ile doğru anda hatırlatılması farklı işlerdir. Bir kayıt veritabanında bulunsa bile arama onu getirmiyorsa model o bilgiden yararlanamaz.
Bilgiler Sisteme Nasıl Ekleniyor?
İlk aşamada belgeler okunur ve kullanılabilir hâle getirilir. PDF, metin dosyası veya e-posta gibi kaynaklarda başlıkların, tabloların ve içerik sırasının doğru çıkarılması önemlidir.
Uzun belgeler genellikle daha küçük parçalara ayrılır. Her parça için embedding oluşturulur ve kaynak bilgileriyle birlikte kaydedilir.
Bir kayıtta şu alanlar bulunabilir:
- Metin parçası ve vektörü.
- Kaynak belgenin kimliği.
- Bölüm veya sayfa bilgisi.
- Oluşturulma ve güncellenme tarihi.
- Belge sürümü.
- Kullanıcı veya kurum bilgisi.
- Erişim koşulları.
Bu alanlar, yalnızca benzer içerik bulmak için değil, bulunan bilginin nereden geldiğini ve hâlâ geçerli olup olmadığını anlamak için de gereklidir.
Kullanıcı Soru Sorduğunda Ne Oluyor?
Kullanıcının sorusu, kayıtlarla karşılaştırılabilecek bir vektöre dönüştürülür. Ardından veritabanında benzer temsiller aranır.
Örneğin kullanıcı:
“Satın aldığım ürünü hangi koşullarda geri verebilirim?”
diye sorabilir. İlgili belgede ise “iade şartları” ifadesi bulunabilir. Uygun bir embedding modeli, farklı kelimelerle anlatılan bu ilişkiyi yakalayabilir.
Arama süreci genel olarak şöyledir:
- Sorgu için sayısal temsil oluşturulur.
- Kullanıcının erişebileceği kayıtlar belirlenir.
- Benzerlik araması yapılır.
- Aday içerikler gerekirse yeniden sıralanır.
- Seçilen parçalar modele bağlam olarak verilir.
- Model bu bilgilerden yararlanarak cevap oluşturur.
Vektör veritabanı bu sürecin arama ve saklama bölümünde görev yapar. Nihai cevabın oluşturulması ise ayrı bir işlemdir.
Benzerlik, Doğruluk Anlamına Gelir mi?
Hayır. Bir belge soruyla anlam bakımından ilişkili olabilir, fakat soruyu cevaplamayabilir.
Örneğin arama, yeni iade politikası yerine eski sürümü getirebilir. İki metin birbirine çok benzediği için yalnızca vektör yakınlığı yeterli olmayabilir.
Benzerlik ölçümleri de farklı davranabilir:
- Cosine Similarity: Vektörlerin yönleri arasındaki benzerliği değerlendirir.
- Dot Product: İç çarpımı kullanır; vektör büyüklüklerinden etkilenebilir.
- Euclidean Distance: Vektörler arasındaki geometrik uzaklığı ölçer.
Uygun ölçü, embedding modelinin özelliklerine bağlıdır. Aramadan dönen puan da genellikle cevabın doğru olma olasılığı değildir.
Bu nedenle tarih, sürüm ve kaynak güvenilirliği gibi kontroller ayrıca uygulanmalıdır.
Yapay Zekâ Ajanlarında Hafıza Nasıl Kuruluyor?
Bir ajan, önceki görevlerden kalan notları veya kullanıcı tercihlerini harici bir sistemde saklayabilir. Vektör araması, yeni görevle ilgili geçmiş kayıtları bulmak için kullanılabilir.
Örneğin kullanıcı daha önce “Raporlarda kısa açıklama ve tablo tercih ediyorum” demişse, bu tercih sonraki rapor görevinde getirilebilir.
Ancak her konuşmayı olduğu gibi hafızaya eklemek iyi bir tasarım değildir. Sistem şu kararları vermelidir:
Ne saklanacak? Geçici bir talep mi, kalıcı tercih mi?
Kimin bilgisi? Kayıt hangi kullanıcıya veya kuruma ait?
Ne kadar geçerli? Tercih değişmiş olabilir mi?
Nasıl silinecek? Kullanıcı kaldırılmasını istediğinde bütün kopyalar güncellenecek mi?
Vektör araması, hafızayı bulmaya yardımcı olur; hafızanın yönetim kurallarını tek başına belirlemez.
SQL Veritabanlarıyla Birlikte Kullanılabilir mi?
Evet. SQL veritabanları yalnızca tam eşleşme yapmaz; filtreleme, hesaplama, birleştirme ve farklı arama özellikleri sunabilir. Bazıları vektör aramasını da destekler.
Bu nedenle vektör araması ile yapısal sorgular birbirini tamamlayabilir.
Örneğin bir ürün aramasında:
- Fiyatın belirli aralıkta olması yapısal filtreyle.
- Stokta bulunması kayıt sorgusuyla.
- Kullanım amacına uygunluğu vektör aramasıyla.
değerlendirilebilir.
“En iyi oyun bilgisayarı” gibi bir sorgu yalnızca anlam benzerliğiyle çözülemez. Bütçe, teknik özellikler ve güncel stok bilgisi de gerekir.
Büyük Koleksiyonlarda Arama Nasıl Hızlanıyor?
Bütün vektörleri tek tek karşılaştırmak, veri büyüdükçe maliyetli olabilir. Bu nedenle yaklaşık en yakın komşu araması, yani ANN, kullanılabilir.
İndeks yapıları, güçlü adaylara daha az karşılaştırmayla ulaşmayı hedefler. Bunun karşılığında her sorguda gerçek en yakın sonuçların tamamının bulunması garanti edilmez.
Hız, bellek kullanımı ve ilgili sonuçları yakalama oranı arasında denge kurulur. Daha hızlı bir indeks, uygulamanın ihtiyaç duyduğu belgeyi kaçırıyorsa yeterli olmayabilir.
Model Değişirse Kayıtlar Ne Olur?
Embedding modeli değiştirildiğinde mevcut vektörlerin yeniden oluşturulması gerekebilir.
İki model aynı sayıda boyut üretse bile bu boyutlar farklı ilişkileri temsil edebilir. Dolayısıyla eski belge vektörleriyle yeni sorgu vektörlerini doğrudan karşılaştırmak güvenilir olmayabilir.
Model sürümü, veri hazırlama yöntemi ve indeks bilgileri birlikte takip edilmelidir. Belgelerin güncellenmesi veya silinmesi de ilgili parçaların yönetilmesini gerektirir; bütün koleksiyonun her değişiklikte yeniden oluşturulması zorunlu değildir.
Gizlilik ve Erişim Kontrolü
Bir içeriğin vektöre dönüştürülmesi, onu anonim hâle getirmez. Embedding’ler hassas bilgilerle ilişkili olabilir; kaynak metinler ve metadata da korunmalıdır.
Kurumsal sistemlerde arama, kullanıcının yetkileriyle sınırlandırılmalıdır. Yetkisiz belgenin modele gönderilip daha sonra cevapta gizlenmeye çalışılması yeterli değildir.
Hafıza kayıtlarında da kullanıcıların verileri ayrılmalı; saklama süresi ve silme süreçleri belirlenmelidir.
Başarılı Bir Hafıza Sistemi Nasıl Anlaşılır?
Yalnızca hızlı sonuç dönmesi yeterli değildir. Sistem doğru kaydı getirmeli, eski bilgiyi ayırt etmeli ve ilgisiz kayıtlarla cevabı bozmayı önlemelidir.
Değerlendirmede şu sorular önemlidir:
- Gerekli bilgi bulundu mu?
- Yanlış kullanıcıya ait kayıt getirildi mi?
- Eski sürüm yeni bilgiyle karıştırıldı mı?
- Kaynak, verilen cevabı gerçekten destekliyor mu?
- Bilgi bulunamadığında sistem bunu açıkça belirtiyor mu?
Böylece “hatırlama” özelliği, yalnızca veri saklamak yerine doğru bilgiyi doğru bağlamda kullanabilmek üzerinden ölçülür.
Sık Sorulan Sorular
Vektör veritabanına belge eklemek modeli eğitir mi?
Hayır. Belge harici sistemde saklanır. Model, aramayla getirilen içeriği bağlam üzerinden kullanır.
Bir bilginin kaydedilmesi, her zaman hatırlanacağı anlamına gelir mi?
Hayır. Sorgu, filtreler ve arama ayarları nedeniyle ilgili kayıt bulunamayabilir.
Her yapay zekâ asistanı için vektör veritabanı gerekir mi?
Hayır. Küçük veri kümeleri, yapısal kayıtlar veya farklı arama ihtiyaçları için başka çözümler yeterli olabilir.
Hafızadaki yanlış bilgi kendiliğinden düzelir mi?
Genellikle hayır. Kaynak güncelleme, kayıt değiştirme ve silme mekanizmaları ayrıca tasarlanmalıdır.
Kaynaklar: Patrick Lewis ve diğerleri — Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks; Yu. A. Malkov ve D. A. Yashunin — Efficient and Robust Approximate Nearest Neighbor Search Using Hierarchical Navigable Small World Graphs; Charles Packer ve diğerleri — MemGPT: Towards LLMs as Operating Systems.
Editör Notu
Bu içerik, vektör veritabanlarının bilgi erişimi ve harici hafıza sistemlerindeki rolünü ele alan bir araştırma ve değerlendirme yazısıdır. İçerikte yer alan değerlendirmeler editoryal yorum niteliğindedir. Bilginin bulunması ve doğru kullanılması; embedding modeline, kayıt kalitesine, erişim kurallarına ve arama yapılandırmasına bağlıdır. Bir kaydın saklanması, modelin onu kalıcı olarak öğrendiğini veya her istekte hatırlayacağını göstermez.






Bunlar da ilginizi çekebilir
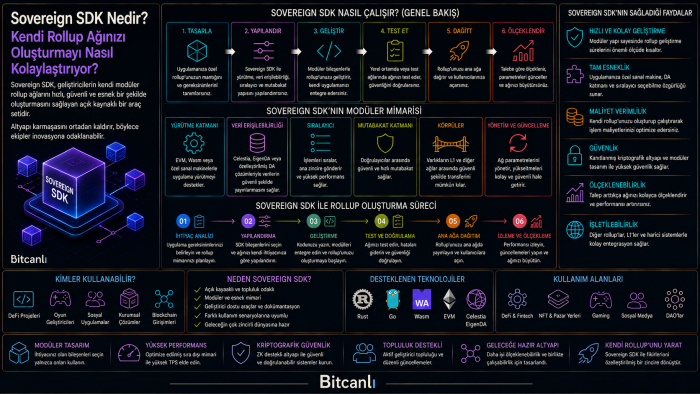
Sovereign SDK Nedir? Kendi Rollup Ağınızı Oluşturmayı Nasıl Kolaylaştırıyor?
Sovereign SDK, geliştiricilerin sıfırdan blockchain altyapısı oluşturmak yerine modüler bileşenleri kullanarak uygulamalarına özel ve özelleştirilebilir rollup'lar geliştirmesini sağlayan açık kaynaklı bir geliştirme kitidir.
1 ay önce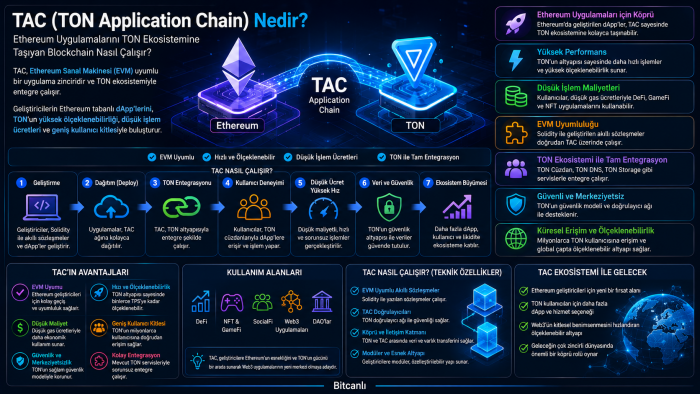
TAC (TON Application Chain) Nedir? Ethereum Uygulamalarını TON Ekosistemine Taşıyan Blockchain Nasıl Çalışır?
TAC (TON Application Chain), EVM uyumlu Ethereum uygulamalarını TON ve Telegram kullanıcılarıyla buluşturmayı amaçlayan blockchain altyapısıdır. EVM uyumluluğu, çalışma modeli ve sunduğu avantajlarla TAC'ın nasıl çalıştığını keşfedin.
1 ay önce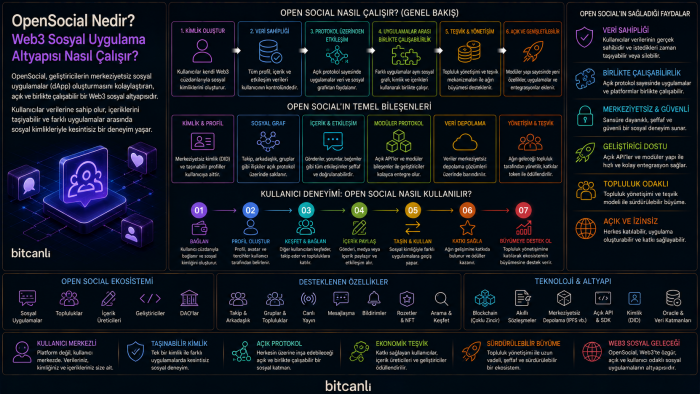
OpenSocial Nedir? Web3 Sosyal Uygulama Altyapısı Nasıl Çalışır?
Web3 sosyal uygulamalarının yaygınlaşmasıyla birlikte geliştiricilerin kullanıcı profilleri, sosyal grafikler, topluluklar ve mesajlaşma gibi temel bileşenleri tekrar tekrar oluşturması önemli bir altyapı ihtiyacı ortaya çıkarıyor. OpenSocial, bu bileşenleri ortak ve modüler bir yapı altında sunarak yeni nesil sosyal uygulamaların geliştirilmesini kolaylaştırmayı amaçlıyor.
1 ay önce