-i6a77249e192b0.png)

En güncel haberleri, analizleri ve rehberleri tek bir yerde arayın.

Bir yapay zekâ uygulamasında yanıtın kalitesi kadar, ne kadar hızlı üretildiği de önemlidir. Uzun bir açıklamanın ekrana yavaşça gelmesi, kod tamamlama aracının bekletmesi veya bir yapay zekâ ajanının her adımda uzun süre duraklaması kullanıcı deneyimini etkileyebilir.
7 saat önce
Bir yapay zekâ modeline soru sorduğunuzda cevabın ekranda parça parça belirdiğini görürsünüz. Bunun nedeni, büyük dil modellerinin metni genellikle bir sonraki tokenı tahmin ederek üretmesidir. Her yeni token, daha önce oluşturulan metne bağlıdır.
7 saat önce
Bir dil modelinin metin üretebilmesi, kullanıcı talimatlarını istenen biçimde yerine getireceği anlamına gelmez. Model bir soruyu yanıtlamak yerine devamını yazabilir, kısa açıklama istendiğinde gereksiz ayrıntılara girebilir veya belirlenen çıktı formatına uymayabilir.
7 saat önce
Üretken yapay zekâ uygulamalarında aynı sistem talimatlarının, araç tanımlarının ve uzun belgelerin tekrar tekrar işlenmesi önemli bir hesaplama yükü oluşturabilir. Kullanıcı sorusu değişse bile modele gönderilen girişin büyük bir bölümü aynı kalabilir.
1 gün önce
Büyük dil modelleri, yanıt üretmeden önce kendilerine gönderilen giriş metnini işler. Bu giriş; sistem talimatlarını, konuşma geçmişini, belgeleri ve kullanıcının sorusunu içerebilir. Ancak birçok uygulamada bu içeriğin önemli bir bölümü her istekte aynıdır.
1 gün önce
Büyük dil modelleri yanıt üretirken önceki tokenlara ait bazı hesaplamaları KV Cache (Key-Value Cache) içinde saklar. Böylece geçmiş metnin aynı hesaplamalarını her adımda yeniden yapmak gerekmez. Ancak uzun bağlamlar ve eş zamanlı istekler, bu önbelleğin önemli miktarda GPU belleği tüketmesine yol...
3 gün önce
Büyük dil modellerinde daha fazla parametre kullanmak, modelin öğrenme kapasitesini artırabilir. Ancak bu büyüme; eğitim, bellek ve çıkarım maliyetlerinin yönetilmesini de zorlaştırır. Araştırmacılar bu nedenle kapasiteyi artırırken her girdide yapılan hesaplamayı sınırlayabilecek mimariler geliştir...
3 gün önce
Büyük dil modelleriyle uzun raporları incelemek, kapsamlı kod dosyalarını karşılaştırmak veya uzun sohbetleri sürdürmek mümkün. Bu uygulamaları destekleyen özelliklerden biri, modellerin uzun bağlam (Long Context) işleyebilme yeteneğidir.
4 gün önce
Büyük dil modellerinin önemli bir bölümü, metni sırayla token üreterek oluşturur. Her adımda yeni tokenın önceki bağlamla ilişkisi değerlendirilir. Geçmiş tokenlara ait bütün hesaplamaların her seferinde yeniden yapılması, üretimi gereksiz yere yavaşlatabilir.
4 gün önce
Büyük dil modellerini belirli bir göreve uyarlamak, modelin bütün parametrelerini yeniden eğitmeyi gerektirmeyebilir. Parametre verimli ince ayar (PEFT) yöntemleri, sınırlı sayıda parametreyi güncelleyerek eğitim ve depolama maliyetlerini azaltmayı amaçlar.
4 gün önce
Yapay zekâ uygulamalarında kullanıcıların gönderdiği istekler aynı uzunlukta değildir. Bir kişi kısa bir tanım isterken başka biri uzun bir rapor veya yüzlerce satırlık kod talep edebilir. Bu farklılık, sunucuların işlem gücünü verimli kullanmasını zorlaştırır.
1 hafta önce
AI Gateway, uygulamalar ile yapay zekâ modelleri arasındaki erişimi yöneten bir ara katmandır. Farklı model sağlayıcılarına gönderilen isteklerin yönlendirilmesini, kullanım sınırlarının uygulanmasını ve maliyetlerin izlenmesini kolaylaştırır. Kurumsal uygulamalarda ortak erişim kurallarının tek nok...
1 hafta önce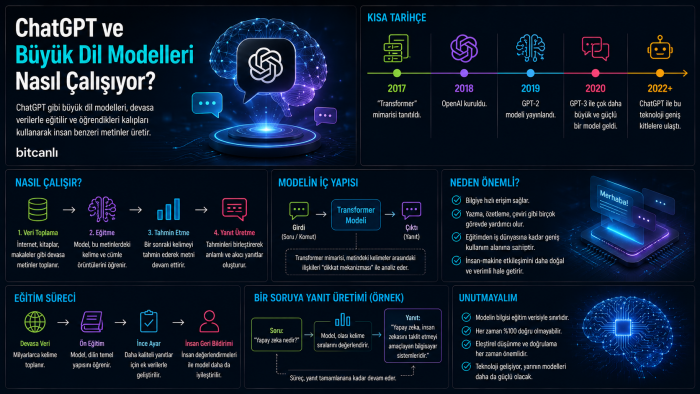
ChatGPT gibi büyük dil modellerinin arkasında hangi teknoloji var? Veriden eğitime, Transformer mimarisinden parametrelere kadar bu sistemlerin nasıl çalıştığını keşfedin.
1 ay önce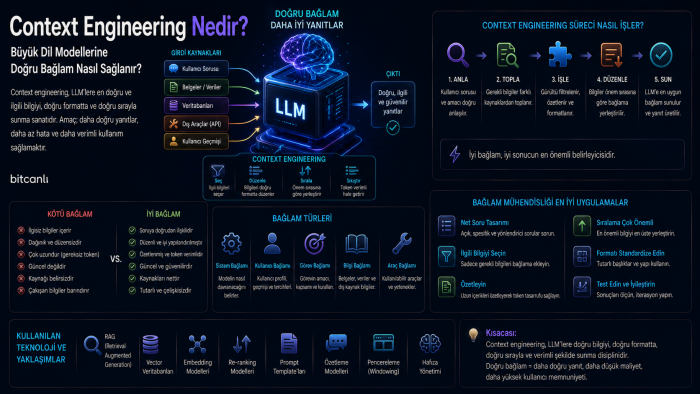
Context Engineering, yapay zekâ modellerine yalnızca iyi bir prompt vermek yerine doğru bilgiyi doğru zamanda seçip sunarak LLM ve AI Agent performansını artırmayı amaçlayan kapsamlı bir yaklaşımdır.
1 ay önce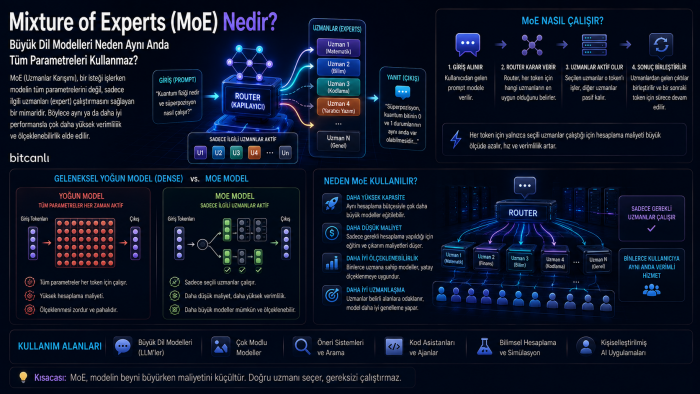
Mixture of Experts (MoE), büyük yapay zekâ modellerinde yalnızca gerekli Expert'leri etkinleştirerek model kapasitesini artırmayı ve hesaplama maliyetini daha verimli yönetmeyi amaçlayan mimaridir.
1 ay önce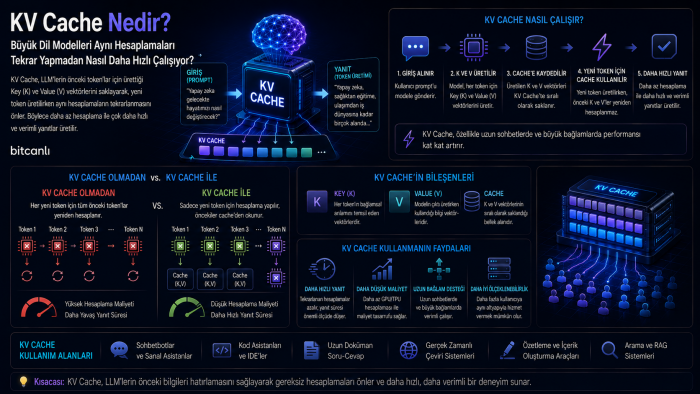
KV Cache, büyük dil modellerinin önceki attention hesaplamalarını yeniden kullanarak inference sürecini daha hızlı ve verimli hâle getirmesini sağlayan temel optimizasyon tekniklerinden biridir.
1 ay önce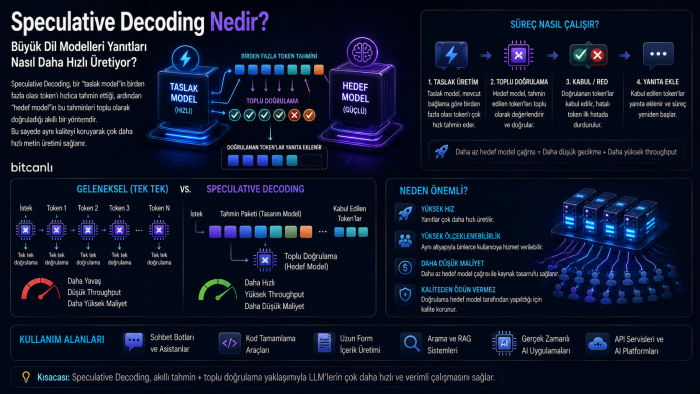
Speculative Decoding, küçük bir yapay zekâ modelinin olası token'ları önceden tahmin etmesi ve büyük modelin bu tahminleri doğrulaması sayesinde LLM'lerin daha hızlı yanıt üretmesini sağlayan önemli bir inference optimizasyon tekniğidir.
1 ay önce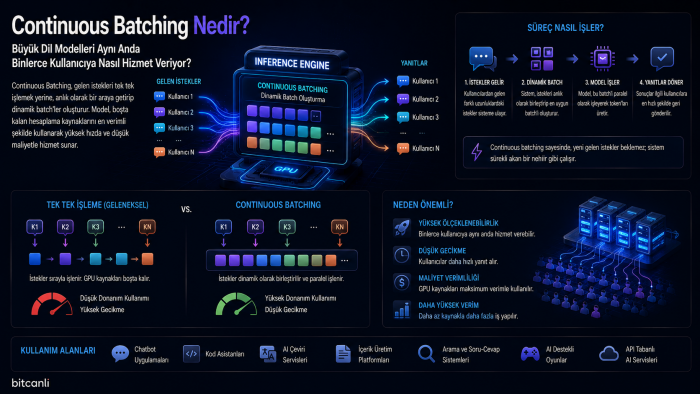
Continuous Batching, farklı zamanlarda gelen kullanıcı isteklerini GPU üzerinde dinamik olarak birleştirerek büyük dil modellerinin aynı donanımla çok daha fazla kullanıcıya verimli şekilde hizmet vermesini sağlayan önemli bir inference optimizasyon tekniğidir.
1 ay önce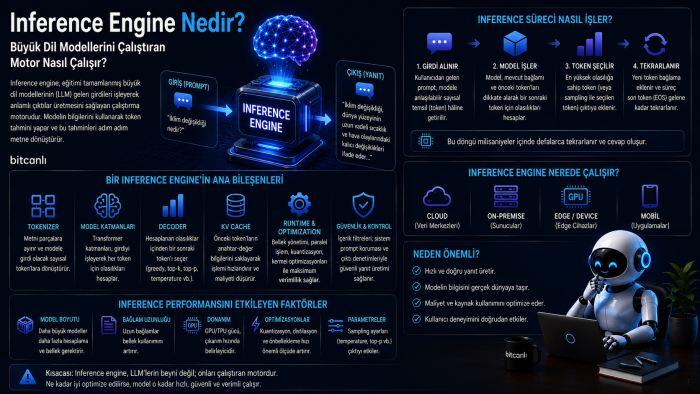
Inference Engine, büyük dil modellerinin kullanıcı isteklerine hızlı ve verimli şekilde yanıt vermesini sağlayan kritik yazılım katmanıdır. Peki bu motorlar GPU belleğini, istekleri ve token üretimini nasıl yönetiyor?
1 ay önce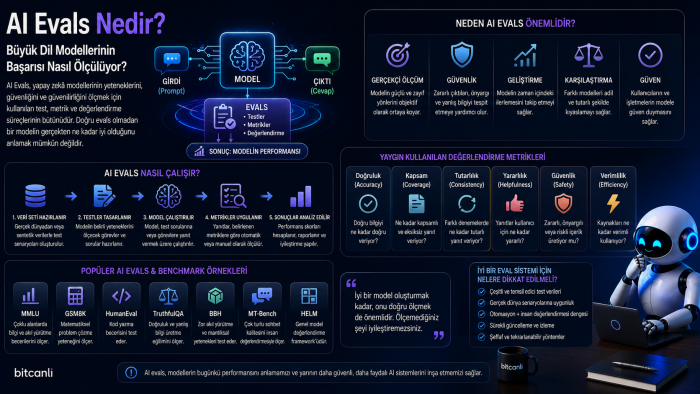
AI Evals, yapay zekâ modellerinin doğruluk, muhakeme, güvenlik ve gerçek dünya performansını sistematik olarak ölçmeyi sağlar. Peki büyük dil modellerinin başarısı hangi testlerle belirleniyor?
1 ay önce