-i6a77249e192b0.png)

En güncel haberleri, analizleri ve rehberleri tek bir yerde arayın.

Büyük dil modellerinin akıcı metin üretmesi, kullanıcıların beklentilerini her zaman karşılayacağı anlamına gelmez. Yanıtların açıklığı, talimatlara uygunluğu ve güvenilirliği için ek eğitim aşamaları uygulanabilir.
5 gün önce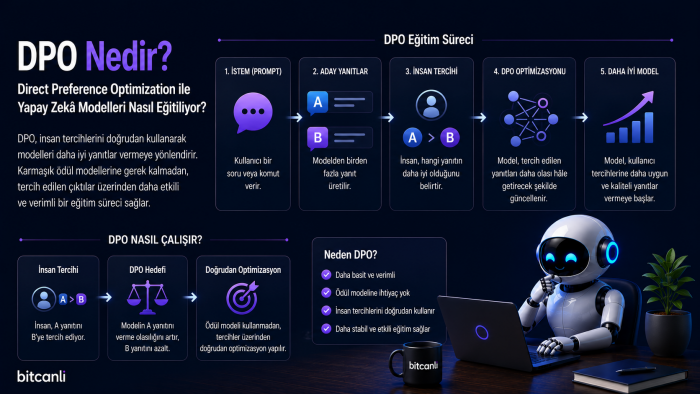
DPO, yapay zekâ modellerinin insan tercihlerine göre daha doğrudan eğitilmesini sağlayan bir yöntem. Peki Direct Preference Optimization nasıl çalışıyor ve RLHF'ten hangi yönleriyle ayrılıyor?
1 ay önce