-i6a77249e192b0.png)

En güncel haberleri, analizleri ve rehberleri tek bir yerde arayın.

Büyük bir yapay zekâ modelini çalıştırırken karşılaşılan sorun yalnızca işlem gücü değildir. Model ağırlıklarının, ara hesaplamaların ve diğer verilerin belleğe sığması da gerekir. Tek bir GPU’nun hesaplama kapasitesi yeterli görünse bile belleği model için yetersiz kalabilir.
5 saat önce
Büyük dil modellerini belirli görevlere uyarlamak, önemli miktarda hesaplama gücü ve bellek gerektirebilir. Özellikle modelin bütün ağırlıklarının güncellendiği tam ince ayar işlemlerinde, ağırlıkların yanında gradyanlar, ara hesaplamalar ve optimizasyon bilgileri de GPU belleğinde yer kaplar.
1 gün önce
Büyük dil modellerinin gelişmesi, yalnızca daha güçlü işlemcilere değil, daha verimli dağıtık hesaplama yöntemlerine de ihtiyaç doğuruyor. Milyarlarca parametreye sahip modellerin ağırlıkları, eğitim sırasında kullanılan ara hesaplamalar ve optimizasyon bilgileri, tek bir GPU’nun belleğini aşabiliyo...
1 gün önce
Büyük dil modelleri yanıt üretirken önceki tokenlara ait bazı hesaplamaları KV Cache (Key-Value Cache) içinde saklar. Böylece geçmiş metnin aynı hesaplamalarını her adımda yeniden yapmak gerekmez. Ancak uzun bağlamlar ve eş zamanlı istekler, bu önbelleğin önemli miktarda GPU belleği tüketmesine yol...
3 gün önce
Büyük yapay zekâ modellerinin eğitimi, çok sayıda verinin tekrar tekrar işlenmesini gerektirir. Bu işlemleri tek bir cihazda yürütmek zaman alabilir. Eğitim yükünün birden fazla GPU’ya dağıtılması, mevcut hesaplama kaynaklarından daha fazla yararlanılmasını sağlar.
1 hafta önce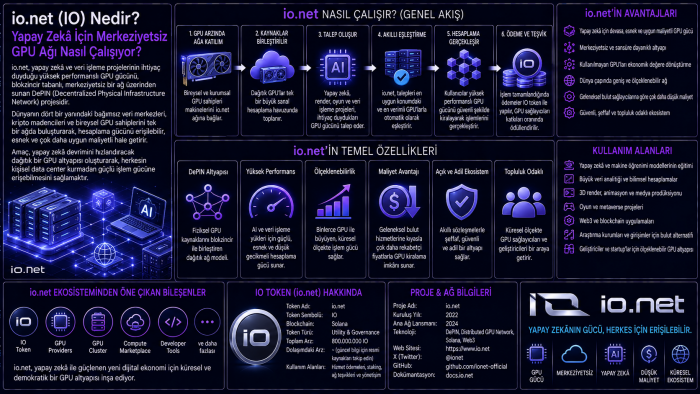
io.net (IO), kullanılabilir GPU kaynaklarını merkeziyetsiz bir ağda birleştirerek yapay zekâ geliştiricilerine daha erişilebilir ve ölçeklenebilir hesaplama altyapısı sunmayı hedefliyor.
1 ay önce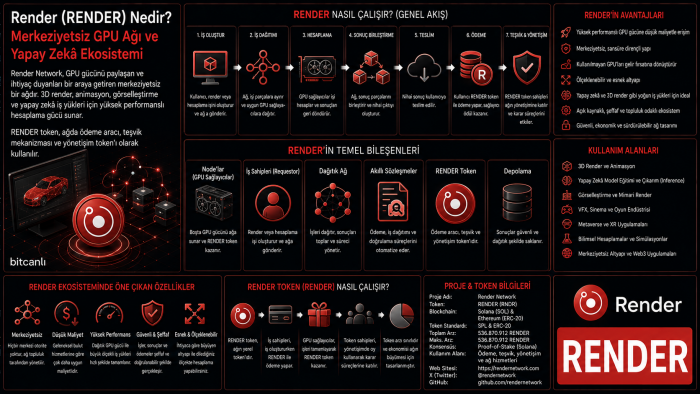
Render (RENDER), kullanılabilir GPU kaynaklarını merkeziyetsiz bir ağda birleştirerek yapay zekâ, 3D render ve dijital içerik üretimi için ölçeklenebilir hesaplama altyapısı oluşturmayı hedeflemektedir.
1 ay önce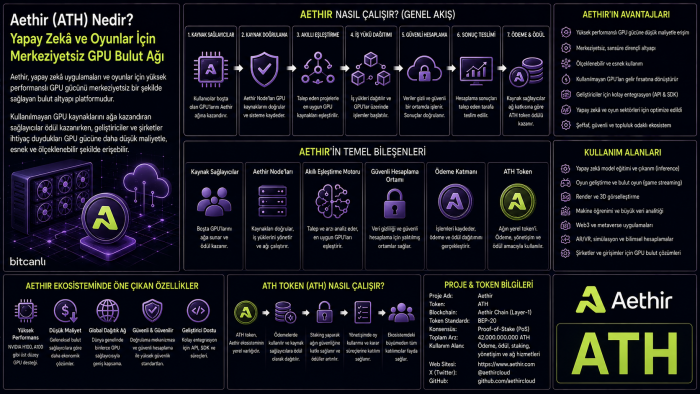
Aethir (ATH), kurumsal GPU kaynaklarını merkeziyetsiz bir ağda birleştirerek yapay zekâ ve bulut oyunları için daha erişilebilir, ölçeklenebilir ve verimli bir hesaplama altyapısı oluşturmayı hedeflemektedir.
1 ay önce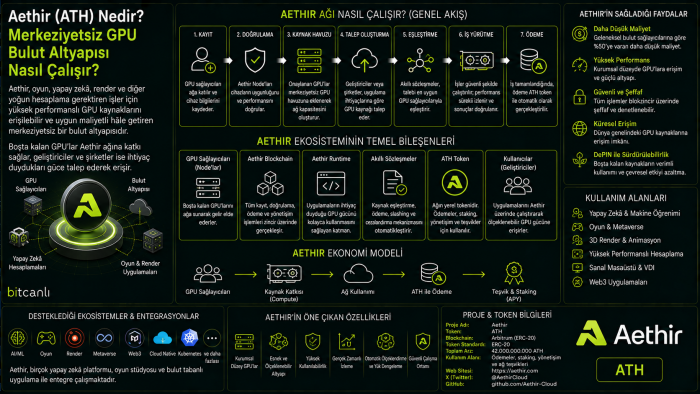
Aethir, yapay zekâ, bulut oyun ve yüksek performanslı uygulamalar için küresel GPU kaynaklarını merkeziyetsiz bir ağda bir araya getiren DePIN projesidir. Platform, kurumsal GPU kapasitesini daha erişilebilir ve esnek hâle getirmeyi amaçlar.
1 ay önce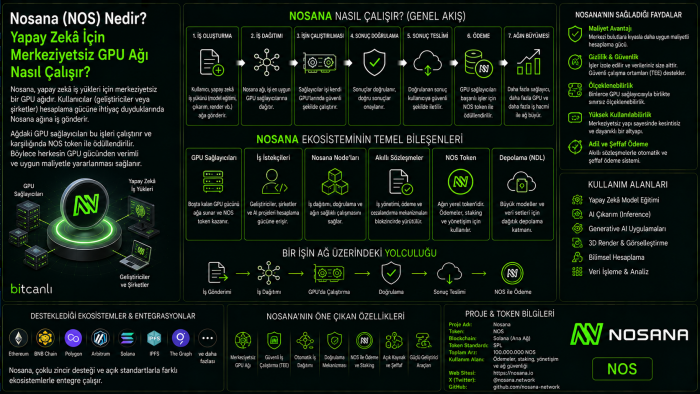
Nosana, yapay zekâ geliştiricilerine merkeziyetsiz GPU işlem gücü sunmayı amaçlayan Solana tabanlı bir DePIN projesidir. Kullanılmayan GPU kaynaklarını bir araya getirerek AI modellerinin eğitimi ve çalıştırılması için alternatif bir hesaplama altyapısı oluşturur.
1 ay önce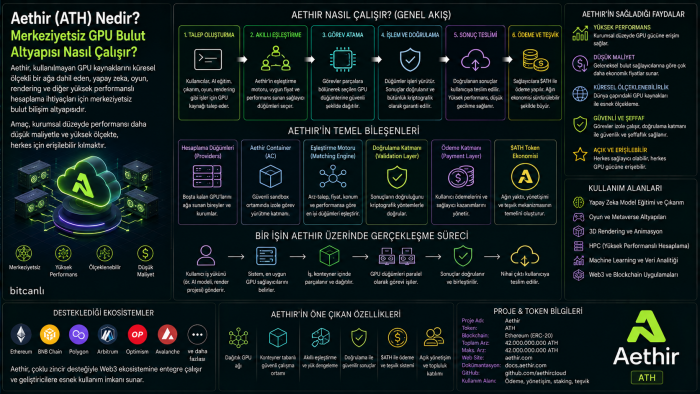
Aethir, yapay zekâ, oyun ve yüksek performanslı bilgi işlem uygulamaları için dağıtık GPU kaynaklarını bir araya getiren DePIN tabanlı altyapıdır.
1 ay önce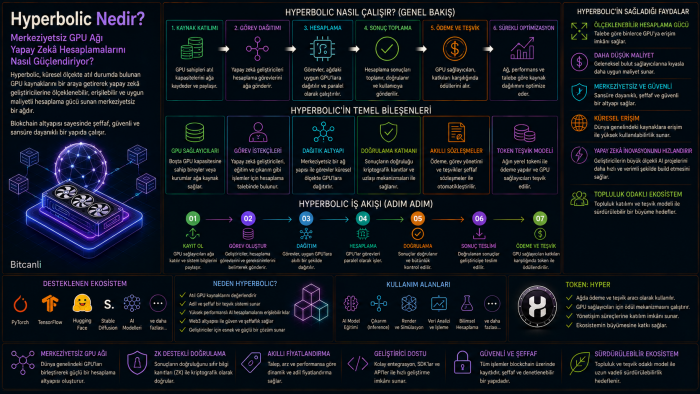
Hyperbolic, farklı GPU sağlayıcılarından gelen hesaplama kapasitesini tek bir altyapıda birleştirerek yapay zekâ geliştiricilerine daha erişilebilir GPU gücü sunmayı hedefliyor. Peki Hyperbolic nasıl çalışıyor, hangi alanlarda kullanılıyor ve merkezi bulut sağlayıcılarından nasıl ayrılıyor?
1 ay önce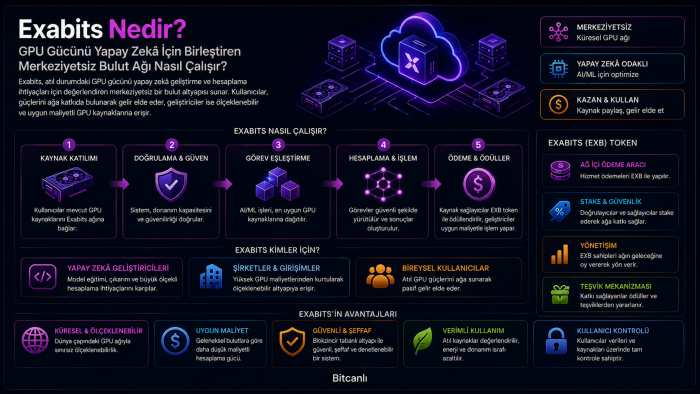
Yapay zekânın ihtiyacı olan devasa GPU gücü nereden gelecek? Exabits, güçlü GPU kümelerini optimize ederek AI geliştiricilerine daha erişilebilir bir compute altyapısı sunmayı hedefliyor.
1 ay önce