-i6a77249e192b0.png)

En güncel haberleri, analizleri ve rehberleri tek bir yerde arayın.

Büyük dil modellerinde daha fazla parametre kullanmak, modelin öğrenme kapasitesini artırabilir. Ancak bu büyüme; eğitim, bellek ve çıkarım maliyetlerinin yönetilmesini de zorlaştırır. Araştırmacılar bu nedenle kapasiteyi artırırken her girdide yapılan hesaplamayı sınırlayabilecek mimariler geliştir...
3 gün önce
Büyük dil modellerinde daha fazla parametre, daha geniş öğrenme kapasitesi sağlayabilir. Ancak modelin büyümesi, hesaplama ve bellek ihtiyacını da artırabilir. Mixture of Experts (MoE), model kapasitesini her token için yapılan hesaplamayla aynı oranda büyütmeden artırmaya yönelik mimari yaklaşımlar...
3 gün önce
Büyük dil modellerinin kapasitesini artırmak için daha fazla parametre kullanmak mümkündür. Ancak model büyüdükçe hesaplama, bellek ve iletişim maliyetleri de önem kazanır. Araştırmacılar bu nedenle model kapasitesini, her girdide yapılacak hesaplamayı aynı oranda artırmadan büyütmenin yollarını gel...
3 gün önce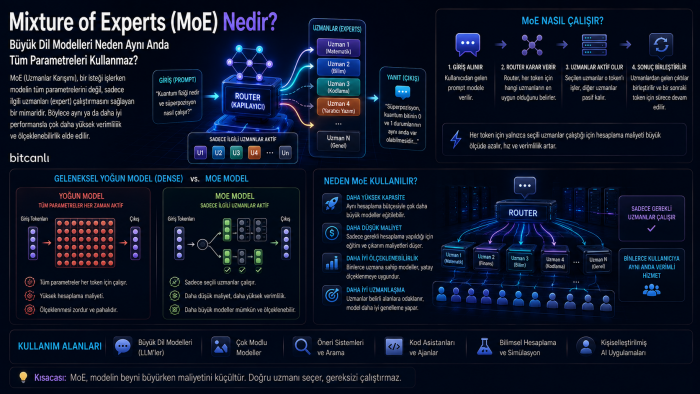
Mixture of Experts (MoE), büyük yapay zekâ modellerinde yalnızca gerekli Expert'leri etkinleştirerek model kapasitesini artırmayı ve hesaplama maliyetini daha verimli yönetmeyi amaçlayan mimaridir.
1 ay önce