-i6a77249e192b0.png)

En güncel haberleri, analizleri ve rehberleri tek bir yerde arayın.

Bir yapay zekâ uygulamasında yanıtın kalitesi kadar, ne kadar hızlı üretildiği de önemlidir. Uzun bir açıklamanın ekrana yavaşça gelmesi, kod tamamlama aracının bekletmesi veya bir yapay zekâ ajanının her adımda uzun süre duraklaması kullanıcı deneyimini etkileyebilir.
7 saat önce
Bir yapay zekâ modeline soru sorduğunuzda cevabın ekranda parça parça belirdiğini görürsünüz. Bunun nedeni, büyük dil modellerinin metni genellikle bir sonraki tokenı tahmin ederek üretmesidir. Her yeni token, daha önce oluşturulan metne bağlıdır.
7 saat önce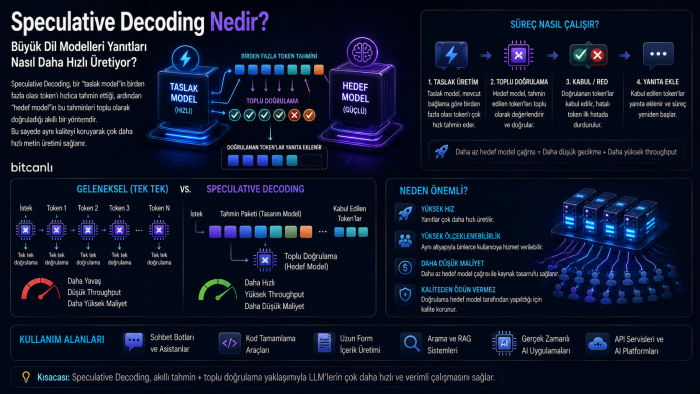
Speculative Decoding, küçük bir yapay zekâ modelinin olası token'ları önceden tahmin etmesi ve büyük modelin bu tahminleri doğrulaması sayesinde LLM'lerin daha hızlı yanıt üretmesini sağlayan önemli bir inference optimizasyon tekniğidir.
1 ay önce