-i6a77249e192b0.png)

En güncel haberleri, analizleri ve rehberleri tek bir yerde arayın.

Büyük dil modellerini belirli görevlere uyarlamak, önemli miktarda hesaplama gücü ve bellek gerektirebilir. Özellikle modelin bütün ağırlıklarının güncellendiği tam ince ayar işlemlerinde, ağırlıkların yanında gradyanlar, ara hesaplamalar ve optimizasyon bilgileri de GPU belleğinde yer kaplar.
1 gün önce
Büyük dil modellerini belirli bir göreve uyarlamak, önemli miktarda bellek ve hesaplama kaynağı gerektirebilir. Tam ince ayar (Full Fine-Tuning) yönteminde önceden eğitilmiş modelin bütün ağırlıkları güncellenir. Model büyüdükçe bu güncellemelerin eğitim ve depolama maliyeti de artabilir.
4 gün önce
Büyük dil modellerini belirli bir göreve uyarlamak, önemli miktarda hesaplama kaynağı gerektirebilir. Tam ince ayar (Full Fine-Tuning) yönteminde modelin bütün ağırlıkları güncellenir. Milyarlarca parametreye sahip modellerde bu süreç, yüksek bellek tüketimi ve eğitim maliyeti oluşturabilir.
4 gün önce
Büyük yapay zekâ modellerini uyarlarken eğitim kapasitesini nereye ayırdığınız, ne kadar kapasite kullandığınız kadar önemlidir. AdaLoRA, sınırlı parametre bütçesini eğitim sırasında yeniden dağıtarak göreve daha fazla katkı sağlayan ağırlık güncellemelerine öncelik vermeyi amaçlar.
1 hafta önce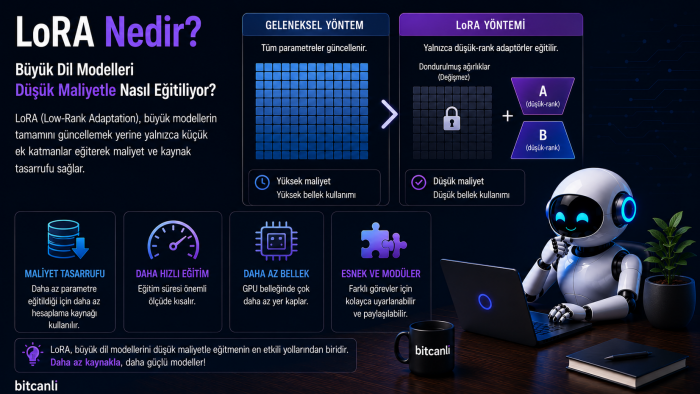
LoRA, milyarlarca parametreyi yeniden eğitmek yerine küçük adaptasyon katmanlarını optimize ederek büyük dil modellerinin daha düşük maliyetle özelleştirilmesini sağlıyor. Peki bu yöntem nasıl çalışıyor ve QLoRA'dan farkı ne?
1 ay önce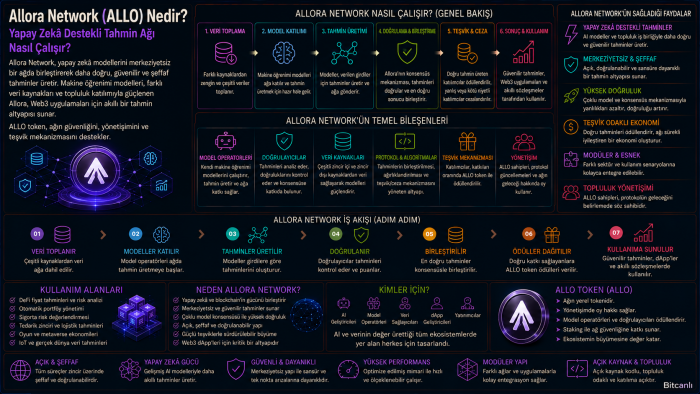
Allora Network (ALLO), farklı yapay zekâ modellerinin birlikte çalışarak tahmin üretmesini ve bu tahminlerin performansa göre değerlendirildiği merkeziyetsiz bir AI altyapısı oluşturmayı hedeflemektedir. Ağ, özellikle veri analizi, finansal tahmin ve karar destek sistemlerinde kullanılabilecek yapay...
1 ay önce